DevOps / Kubernetes
쿠버네티스 클러스터 아키텍처 (1) — Container, Pod, Node, Cluster
2026년 9월 9일
쿠버네티스를 본격적으로 파기 전에, 이게 왜 등장했는지랑 Container / Pod / Node / Cluster 네 가지 기본 용어가 각각 뭘 가리키는지부터 정리해두려고 한다. 여기를 잡아두면 뒤에 나오는 컴포넌트 구조를 볼 때 훨씬 수월할 것 같았다.
Container / Pod / Node / Cluster / Control Plane / Worker Node
쿠버네티스가 없을 때
컨테이너 자체(Docker)는 쿠버네티스보다 먼저 있었다. 문제는 이 컨테이너를 서버 여러 대에 나눠 실행할 때였다. 예전에는 운영자가 서버마다 직접 접속해서 컨테이너를 하나씩 띄웠다.
운영자가 직접:
  server-1에 SSH 접속 → docker run app       (3개 실행)
  server-2에 SSH 접속 → docker run app       (2개 실행)
  server-3에 SSH 접속 → docker run redis     (1개 실행)

  - 어느 서버에 몇 개 떠 있는지  → 문서로 수기 관리
  - 컨테이너가 죽으면           → 사람이 확인하고 다시 docker run
  - 트래픽이 늘면              → 사람이 판단해서 SSH 접속 후 추가 실행
  - 서버가 죽으면             → 그 서버의 컨테이너를 어디로 옮길지 사람이 결정
컨테이너가 한두 개일 때는 이렇게 해도 큰 문제가 없다. 하지만 서버와 컨테이너 수가 늘어나기 시작하면 한계가 보인다.
- 컨테이너나 서버가 새벽에 죽으면, 사람이 복구할 때까지 서비스가 멈춘다.
- 서버 10대에 컨테이너 200개를 어디에 배치할지 사람이 일일이 계산하는 건 현실적으로 무리다.
- 지금 컨테이너가 총 몇 개, 어느 서버에, 정상으로 떠 있는지 한눈에 볼 방법이 없다.
- 서버마다 사람이 손으로 명령하다 보면 서버별 상태가 조금씩 달라진다.
결국 이 한계들은 하나로 모인다. 운영자가 원하는 최종 상태(예: nginx 3개 항상 실행)를 시스템이 스스로 유지해주지 못한다는 점이다.
쿠버네티스가 문제를 해결하는 방식
쿠버네티스는 선언형(declarative) 방식과 컨트롤 루프(control loop)로 이 문제를 푼다.
[ 명령형 - 이전 방식 ]           [ 선언형 - 쿠버네티스 ]
"이 서버에 nginx 실행해"    →    "nginx는 항상 3개 있어야 한다"
 (How: 어떻게 할지 지시)          (What: 원하는 상태만 선언)
                                        │
                                시스템이 알아서 3개를 맞춘다.
                                1개가 죽으면 → 자동으로 1개를 더 생성
운영자는 무엇을 원하는지(What)만 선언하고, 그 상태를 어떻게 만들고 유지할지(How)는 쿠버네티스가 맡는다. 이 구조가 실제로 어떻게 돌아가는지 보기 전에, 용어부터 정리한다.
기본 용어 — Container / Pod / Node / Cluster
이 네 가지는 포함 관계로 보면 안 헷갈린다. 작은 것부터 큰 것 순서다.
Container  ⊂  Pod  ⊂  Node  ⊂  Cluster
(가장 작음)                    (가장 큼)
전체를 그림으로 그리면 이렇다.
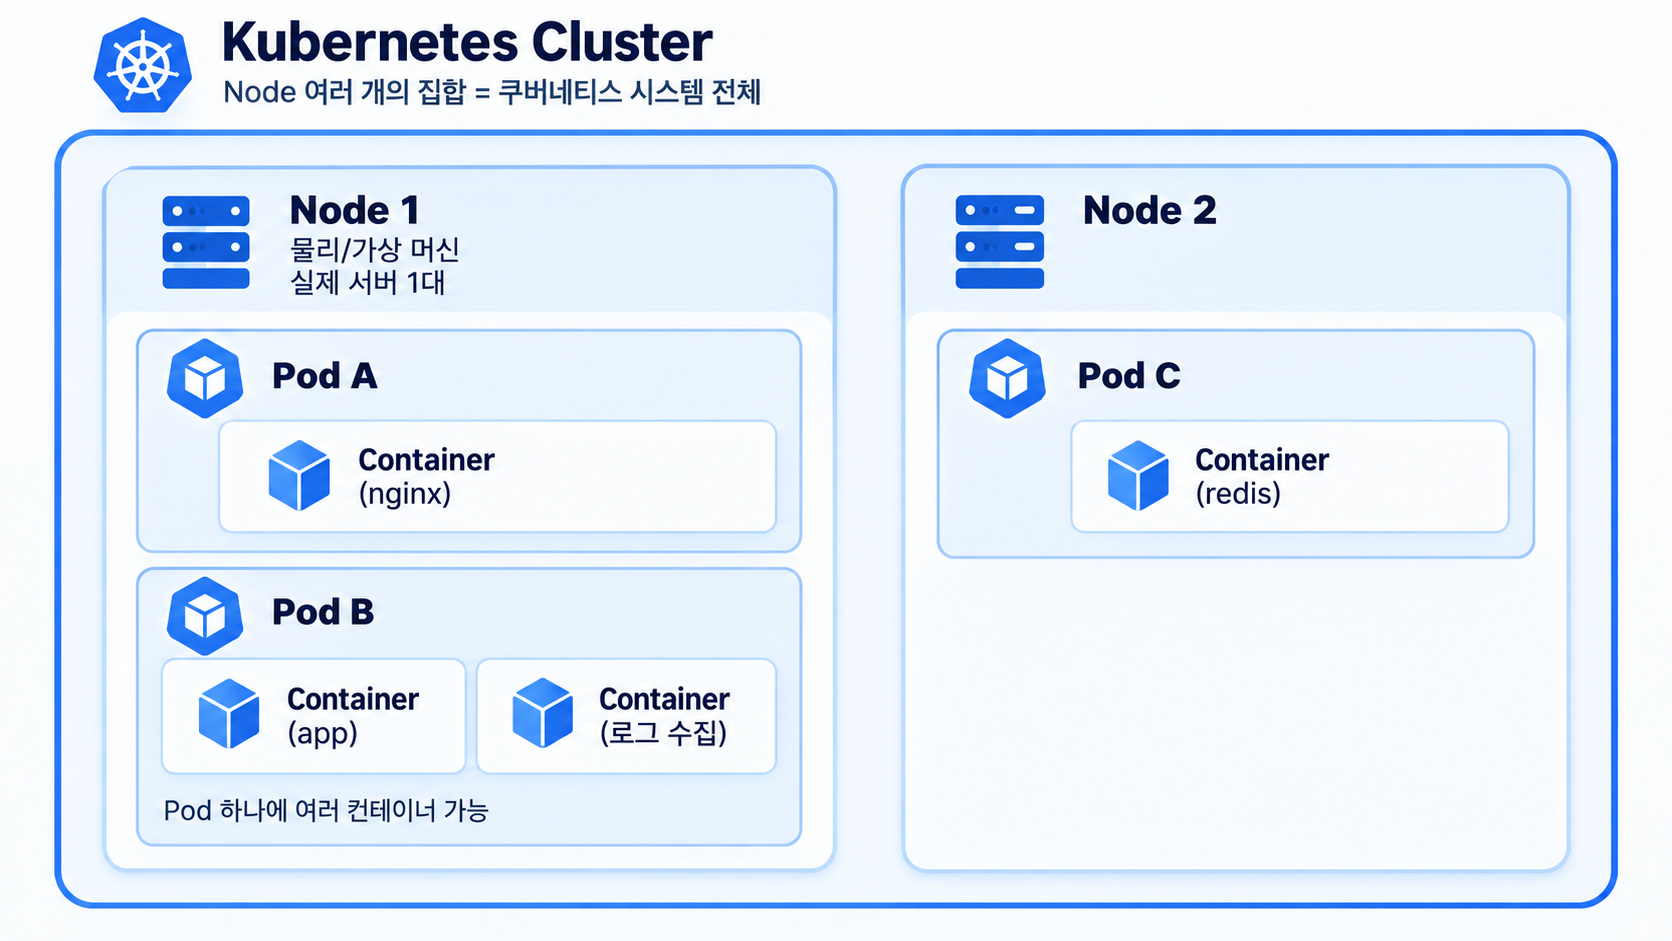
Container
애플리케이션과 실행에 필요한 의존성(bin/lib)이 담긴 실행 단위다.
Pod
쿠버네티스의 최소 배포 단위다. 쿠버네티스는 컨테이너를 직접 다루지 않고, 컨테이너를 Pod로 감싸서 다룬다.
- Pod 하나에는 컨테이너가 1개(대부분)나 여러 개 들어갈 수 있다.
- 한 Pod 안의 컨테이너들은 IP와 네트워크를 공유한다. 같은 NET namespace를 쓰기 때문인데, 그래서 서로 localhost로 통신할 수 있다.
- 한 Pod에 여러 컨테이너를 넣는 대표적인 예가 사이드카다. 앱 컨테이너 옆에 로그 수집 컨테이너를 같이 두는 식이다.
- 굳이 Pod로 감싸는 이유는, 함께 떠야 하고 함께 내려가야 하는 컨테이너들을 하나의 단위로 스케줄·관리하기 위해서다.
Node
Pod가 실제로 돌아가는 서버 1대다. 물리 서버든 EC2 같은 가상 서버든, 머신 한 대가 노드 하나가 된다.
"노드 10대 중 어디에 배치할까?"라는 말은, 지금 클러스터를 이루는 서버 10대 중 어느 서버에 이 Pod를 띄울지를 뜻한다.
노드는 역할에 따라 두 가지로 나뉜다.
- Control Plane Node(마스터): 클러스터의 제어를 맡는다. 스케줄링과 상태 관리를 담당하고 kube-apiserver, etcd, kube-scheduler 등이 여기 있다.
- Worker Node: 실제 사용자 Pod가 돌아가는 서버다. kubelet과 컨테이너 런타임이 여기 있다.
Cluster
Control Plane Node와 Worker Node를 전부 합친 게 클러스터다. 이 전체가 하나의 쿠버네티스 시스템이다.
정리
| 용어 | 정의 |
|---|---|
| Container | 앱 + 의존성이 담긴 실행 단위 |
| Pod | 컨테이너를 감싼 쿠버네티스 최소 배포 단위. 한 Pod 내 컨테이너는 네트워크(IP) 공유 |
| Node | Pod가 실제로 실행되는 서버 1대 (Control Plane / Worker로 구분) |
| Cluster | Control Plane + Worker Node 전체 = 쿠버네티스 시스템 전체 |