DevOps / Kubernetes
쿠버네티스 클러스터 아키텍처 (2) — Control Plane / Worker Node 컴포넌트
2026년 9월 9일
Container / Pod / Node / Cluster 개념과 쿠버네티스가 원하는 상태를 스스로 유지하는 방식으로 문제를 해결한다는 것까지 이해했다. 이제 그 동작을 실제로 담당하는 컴포넌트들을 하나씩 정리한다.
kube-apiserver / etcd / scheduler / controller-manager / kubelet / kube-proxy
두 종류의 노드
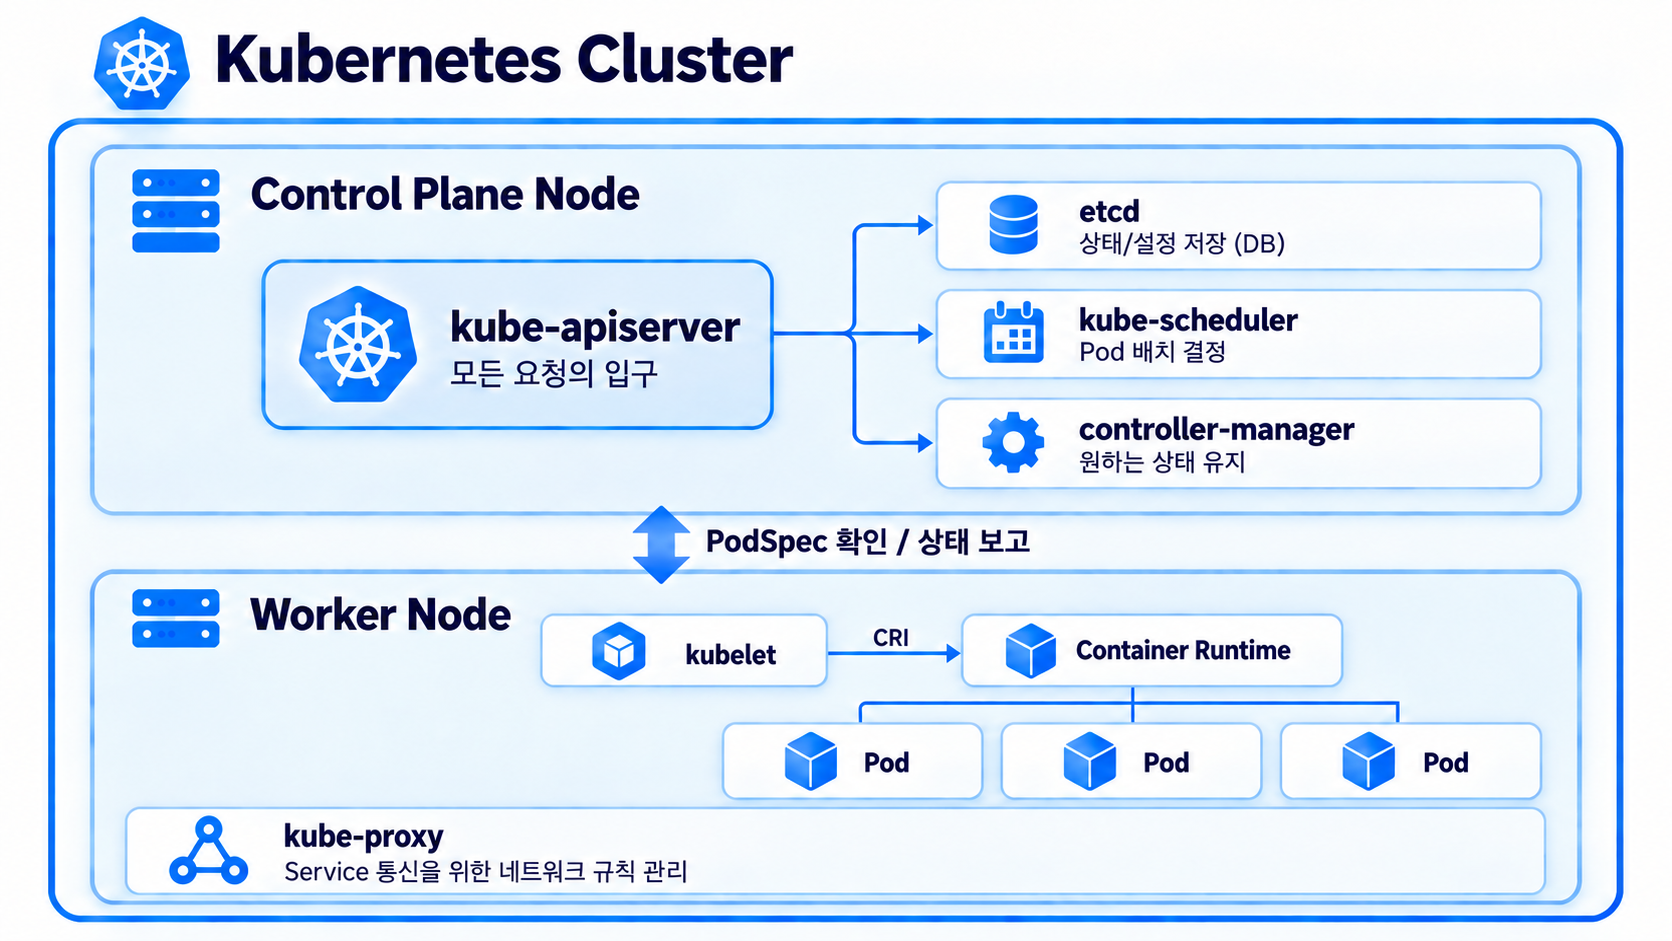
Control Plane은 직접 웹 서버 같은 애플리케이션을 실행하는 것이 주 목적이 아니다. 대신 어느 서버에 무엇을 실행할지, Pod가 죽었을 때 어떻게 처리할지, 현재 클러스터 상태가 어떤지 같은 것을 관리한다. Worker Node는 실제 애플리케이션(사용자 Pod)이 돌아가는 서버다.
두 노드는 한 방향으로만 이어지지 않는다. Control Plane은 각 Pod가 어떤 상태여야 하는지(PodSpec)를 Worker Node에 내려보내고, Worker Node의 kubelet은 실제로 그 Pod가 어떻게 돌아가고 있는지를 다시 apiserver에 보고한다. 그림 가운데의 양방향 화살표가 이 왕복을 나타낸다.
Control Plane 컴포넌트
kube-apiserver
kubectl get pods나 kubectl create deployment nginx --image=nginx 같은 명령을 실행하면, 그 요청은 etcd나 Worker Node로 직접 가지 않는다. 반드시 kube-apiserver를 거친다.
나 → kubectl → kube-apiserver
                    │
                    ├── etcd
                    ├── scheduler
                    ├── controller-manager
                    └── kubelet
etcd, scheduler, controller, kubelet 같은 다른 컴포넌트도 서로 직접 대화하지 않고 apiserver를 중심으로 통신한다. apiserver는 클러스터에서 유일하게 etcd에 직접 접근하는 컴포넌트이고, 나머지는 전부 apiserver를 통해서만 상태를 읽고 쓴다. 거의 모든 요청이 apiserver를 중심으로 움직인다고 이해하면 된다.
apiserver가 죽으면 클러스터 조작 자체가 불가능해진다(kubectl이 동작하지 않음). 다만 이미 떠 있는 Pod는 계속 동작한다.
etcd
etcd는 key-value 저장소로, 클러스터의 모든 상태 정보를 저장한다.
etcd에 저장되는 것 (예):
  현재 Node       = 3개
  Deployment      = replicas 3
  Service         = ...
  ConfigMap       = ...
  Secret          = ...
  Pod 정보        = ...
즉 클러스터가 어떤 상태여야 하는가에 대한 원본 데이터가 전부 여기에 있다. etcd가 죽으면 클러스터가 상태를 기억하지 못하고, 백업이 없으면 복구가 불가능하다. 그래서 etcd를 주기적으로 백업해두는 것이 중요하다.
kube-scheduler
새로 생성되는 Pod를 어느 Node에 놓을지 결정한다. 각 Worker Node의 자원 여유, affinity 규칙 등을 apiserver를 통해 읽어서 배치 위치를 정한다.
여기서 주의할 점은, scheduler는 위치를 결정만 한다는 것이다. 실제로 Pod를 그 노드에 띄우는 것은 뒤에 나올 kubelet의 일이다. scheduler가 죽으면 새 Pod가 배치될 노드를 정하지 못해 Pending 상태에서 멈춘다.
kube-controller-manager
원하는 상태와 실제 상태를 계속 비교해서 맞추는 역할을 한다.
예: nginx Pod를 항상 3개 원하는 경우

  원하는 상태 = 3개
  실제 상태   = 3개   → 일치, 아무 것도 안 함
       │
   Pod 1개가 죽음
       │
  실제 상태   = 2개   → 차이 발견 (3 ≠ 2)
       │
  새 Pod 1개 생성 → 실제 상태 다시 3개
이 반복 동작이 쿠버네티스 자가 복구(self-healing)의 핵심이다. controller-manager가 죽으면 자동 복구와 스케일이 동작하지 않고, 죽은 Pod가 재생성되지 않는다.
Worker Node 컴포넌트
kubelet
각 Worker Node마다 kubelet이 하나씩 있다.
Control Plane ──(이 Pod 실행해)──▶ kubelet ──(CRI)──▶ Container Runtime ──▶ Podkubelet은 단순히 apiserver의 지시를 받아 Pod를 배포·삭제만 하는 존재가 아니다. 자기 노드에서 Pod가 제대로 실행되고 있는지 지속적으로 관리하고, 그 상태를 apiserver에 보고하는 각 노드의 관리자로 이해하는 편이 정확하다. kubelet이 죽으면 그 노드가 NotReady 상태가 되고 새 Pod를 띄울 수 없다.
Container Runtime
kubelet의 지시를 받아 실제 컨테이너를 만든다.
kubelet ──(CRI: 컨테이너 실행해)──▶ containerd ──▶ nginx container과거에는 쿠버네티스가 Docker를 런타임으로 직접 사용하기 위해 dockershim이라는 어댑터를 사용했지만, 이 방식은 없어졌다. 현재는 containerd, CRI-O 같은 CRI 호환 런타임을 사용한다.
여기서 CRI(Container Runtime Interface)는 kubelet과 컨테이너 런타임 사이의 표준 인터페이스다. kubelet이 CRI라는 공통 규격으로 "컨테이너를 실행해"라고 지시하면, 그 규격을 지키는 런타임은 종류가 달라도 kubelet 입장에서는 똑같이 다뤄진다. 덕분에 쿠버네티스가 특정 런타임에 묶이지 않는다.
참고로 Docker로 빌드한 이미지는 OCI 표준이라 지금도 그대로 동작한다. Docker 이미지가 안 된다는 뜻이 아니라, 런타임 데몬으로서의 Docker를 kubelet이 직접 쓰지 않는다는 뜻이다.
kube-proxy
Service로 들어온 트래픽이 적절한 Pod로 전달되도록, 각 노드의 네트워크 규칙(iptables 또는 IPVS)을 관리한다. kube-proxy가 죽으면 Service를 통한 통신이 깨진다.
Deployment — Pod를 원하는 상태로 관리하는 리소스
쿠버네티스의 Deployment는 서버 자체를 배포하는 것이 아니라, 이미 준비된 Worker Node 위에 애플리케이션 Pod를 원하는 상태로 실행·관리하는 리소스다.
서버(Worker Node)는 이미 준비되어 있음
                 │
Deployment: "nginx Pod를 3개 유지해줘"
                 │
                 ▼
ReplicaSet: Pod 개수 3개 유지
                 │
                 ▼
Pod ── nginx Container
Pod ── nginx Container
Pod ── nginx Container
예를 들어 다음 명령을 보자.
kubectl create deployment nginx --image=nginx --replicas=3이 명령은 nginx 이미지로 실행되는 Pod 3개를 만들고, 앞으로도 3개가 유지되도록 관리하는 Deployment를 생성하라는 뜻이다. Deployment가 담당하는 일은 다음과 같다.
- 필요한 Pod 개수 유지
- Pod가 사라지면 새 Pod 생성
- 컨테이너 이미지 버전 업데이트
- 새 버전으로 점진적 교체(Rolling Update)
- 문제가 생기면 이전 버전으로 되돌리기(Rollback)
관계로 정리하면 Deployment → ReplicaSet → Pod다. Deployment는 버전과 배포 전략을 관리하고, 실제로 Pod 개수를 맞추는 일은 그 아래의 ReplicaSet이 맡는다.
전체 흐름 한 번에 보기
kubectl create deployment nginx --image=nginx를 실행했을 때의 흐름이다.
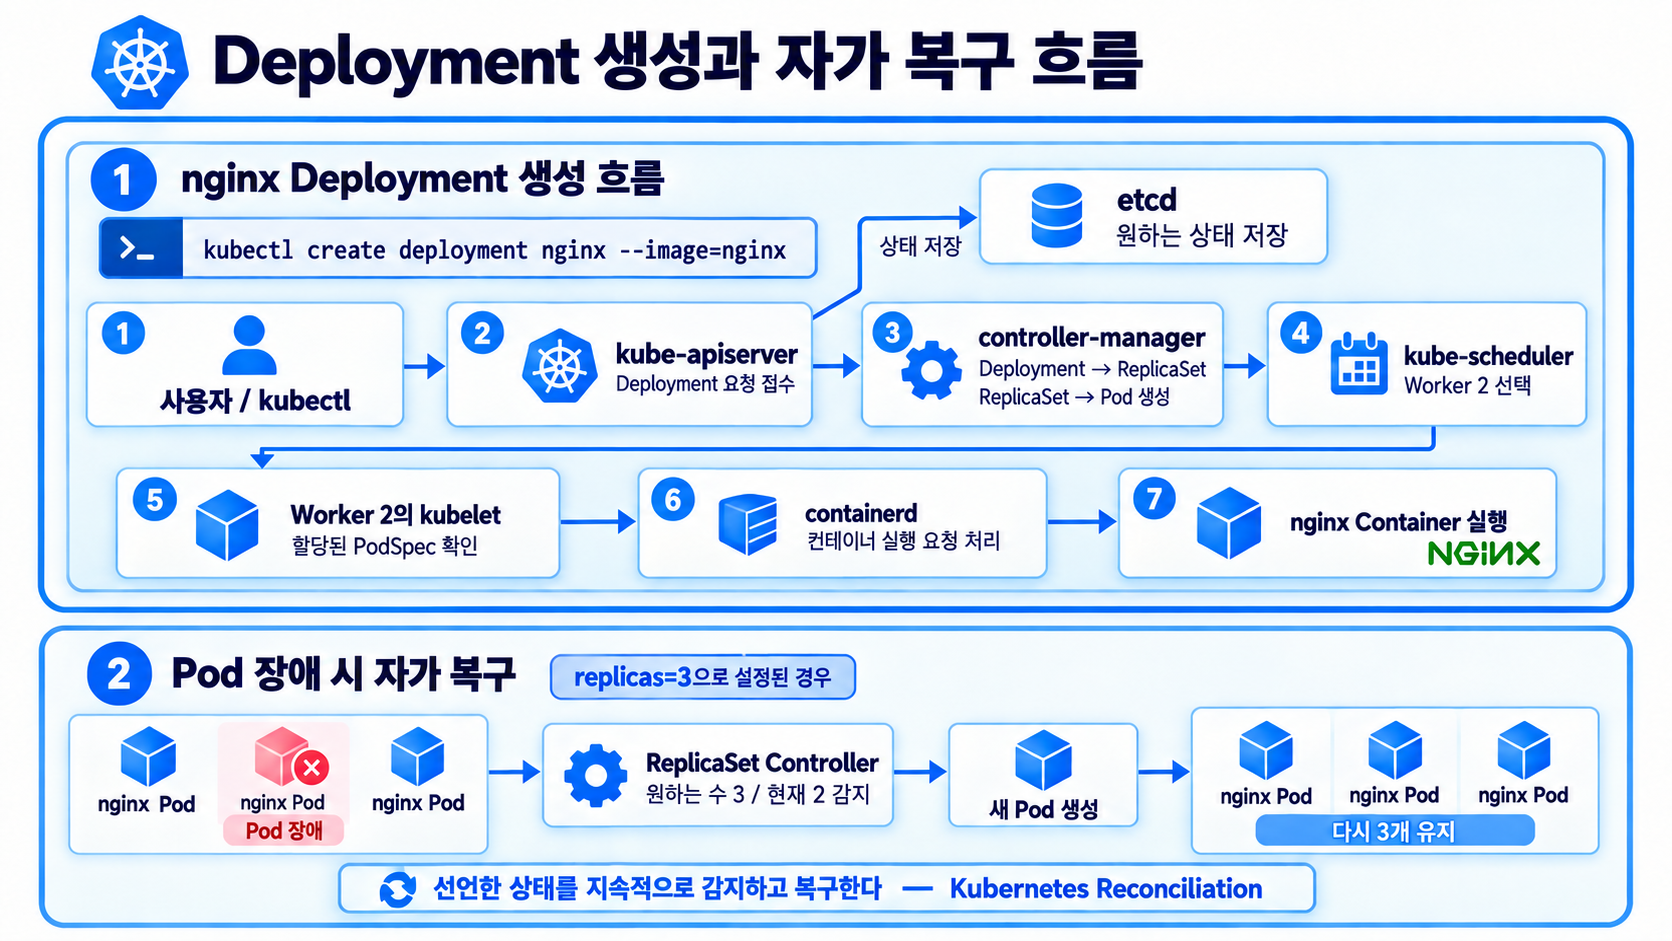
그리고 실행 중이던 nginx Pod가 죽으면 다음과 같이 동작한다.
nginx Pod 죽음
     │
     ▼
controller-manager
"3개 있어야 하는데 2개다"
     │
     ▼
새 Pod 생성 → 다시 3개
선언한 상태를 스스로 감지하고 복구하는 이 동작이 쿠버네티스의 핵심 원리다.
정리
| 컴포넌트 | 위치 | 역할 |
|---|---|---|
| kube-apiserver | Control Plane | 모든 요청의 입구. etcd에 접근하는 유일한 컴포넌트 |
| etcd | Control Plane | 클러스터 상태를 저장하는 key-value DB |
| kube-scheduler | Control Plane | 새 Pod를 어느 Node에 놓을지 결정 |
| controller-manager | Control Plane | 원하는 상태와 실제 상태를 비교·복구 |
| kubelet | Worker Node | 노드의 Pod 실행·관리, 상태 보고 |
| Container Runtime | Worker Node | 실제 컨테이너 생성 (containerd 등) |
| kube-proxy | Worker Node | Service 트래픽을 위한 노드 네트워크 규칙 관리 |
한 가지 규칙만 기억하면 된다. 모든 컴포넌트는 서로 직접 통신하지 않고 반드시 kube-apiserver를 거친다.