DevOps / Kubernetes
쿠버네티스 클러스터 아키텍처 (3) — 컨테이너 생성 스택 (CRI / OCI)
2026년 9월 10일
kubelet은 Container Runtime에 지시해 컨테이너를 만든다. 평소에 kubectl만 쓰면 이 아래 런타임 내부는 보이지 않지만, Pod가 안 뜰 때 어디서 막혔는지 진단하려면 알아야 하는 구조라, kubectl apply 한 줄로 실제 컨테이너가 뜨기까지 누가 누구에게 무엇을 시키는지 순서대로 따라가 본다.
CRI / OCI / kubelet / containerd / runc
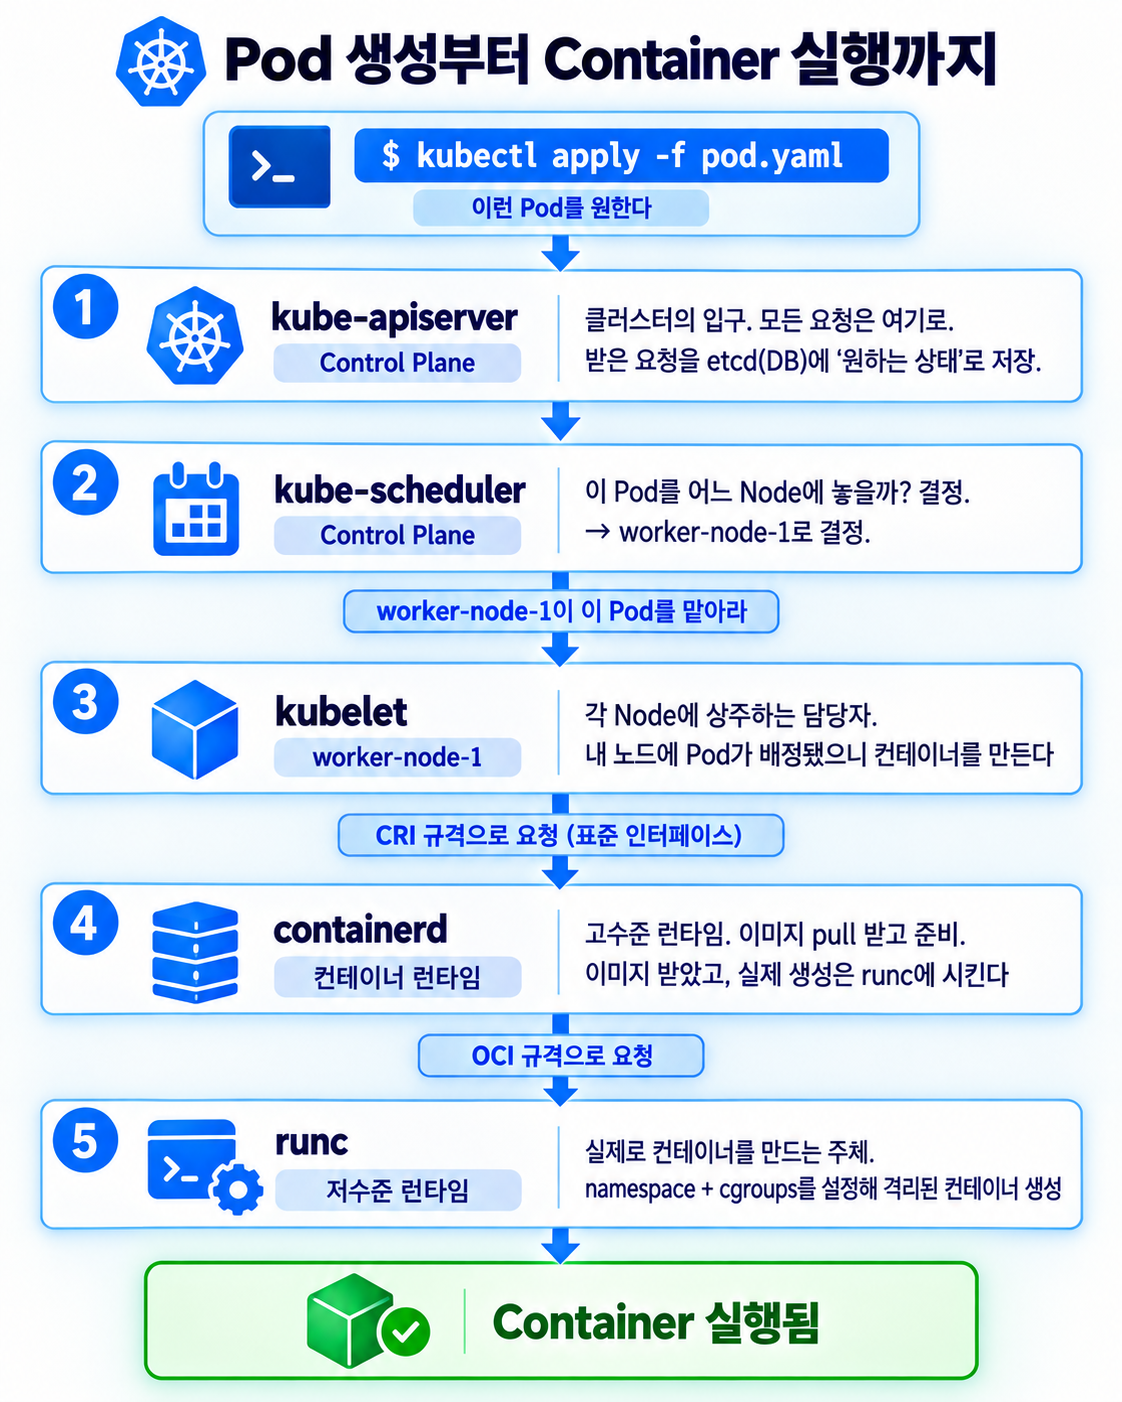
이 흐름에서 apiserver → scheduler → kubelet까지는 컴포넌트들이 요청을 넘기는 앞단이고, 이 글의 초점은 kubelet 이후 — 실제 런타임 3단계다.
실제 런타임 3단계
여기서 런타임은 실제로 컨테이너를 만들고 실행하는 프로그램이다. kubelet은 직접 만들지 않고 런타임에 시키기만 한다. 런타임은 역할에 따라 둘로 나뉜다. 고수준 런타임(containerd)은 이미지 pull·저장 같은 관리를 맡고, 저수준 런타임(runc)은 namespace·cgroups로 실제 컨테이너를 만드는 핵심만 담당한다. 자주 바뀌는 관리 부분과 보안이 중요한 생성 핵심을 분리해두면, 고수준을 갈아끼워도 runc는 그대로 둘 수 있다.
| 컴포넌트 | 구분 | 하는 일 |
|---|---|---|
| kubelet | 노드 담당자 | 각 노드마다 1개씩 상주. 자기 노드에 배정된 Pod를 실제로 띄우고 상태를 apiserver에 보고 |
| containerd | 고수준 런타임 | 이미지 다운로드·관리, runc 호출 |
| runc | 저수준 런타임 | namespace / cgroups를 걸어서 실제 컨테이너를 생성 |
정리하면 kubelet은 만들라고 시키고, containerd는 이미지를 준비하고, runc는 실제로 격리된 컨테이너를 만든다.
여기서 runc가 적용하는 격리는 namespace와 cgroups다.
- namespace: 프로세스가 보는 자원(PID / NET / MNT 등)을 격리해서, 옆 컨테이너를 보지 못하게 한다.
- cgroups: CPU·메모리 사용량 상한을 건다. 쿠버네티스의 resources.limits가 결국 이 값을 설정한다.
단계를 잇는 두 표준 — CRI와 OCI
각 단계 사이의 통신은 임의의 방식이 아니라 표준 인터페이스를 따른다. 이 표준 덕분에 부품을 교체해도 전체가 그대로 동작한다. 그리고 이 두 표준은 서로 다른 층의 약속이다.
kubelet
   │
   │  ◀── CRI (Container Runtime Interface)
   │      kubelet ↔ 컨테이너 런타임 사이의 표준 gRPC 규격
   ▼
containerd  (또는 CRI-O)
   │
   │  ◀── OCI (Open Container Initiative)
   │      런타임 ↔ 저수준 런타임 사이의 표준.
   │      이미지 포맷과 컨테이너 실행 방식의 표준
   ▼
runc- CRI (Container Runtime Interface) — kubelet과 컨테이너 런타임 사이의 표준 API(gRPC)다. "이미지 받아라 / 컨테이너 만들어라 / 상태 알려줘" 같은 명령을 규격으로 정해둔다. 런타임이 CRI만 지키면 kubelet은 containerd든 CRI-O든 똑같이 다루므로, 런타임을 바꿔도 kubelet은 그대로다. → 위쪽 이음새(kubelet ↔ 런타임).
- OCI (Open Container Initiative) — 이미지와 실행 방식의 표준이다. 이미지 포맷 표준 덕분에 어디서 빌드한 이미지든 다른 런타임에서 그대로 돌고, 런타임 스펙 표준을 runc가 구현해 실제 격리 실행을 담당한다. → 아래쪽 이음새(런타임 ↔ runc)와 이미지 포맷.
Docker는 한 덩어리가 아니다
Docker는 사실 여러 층이 쌓인 스택이다.
Docker (제품)
  = docker CLI + dockerd(데몬) + containerd + runc
즉 Docker 내부에도 containerd가 들어 있고, 그 안에서 runc를 부른다. 그런데 containerd는 2017년에 CNCF로, runc는 2015년에 OCI로 기증되면서 각각 독립 프로젝트가 됐다. 그래서 지금은 Docker를 설치하지 않고 containerd만 따로 설치해서 쿠버네티스 런타임으로 쓸 수 있고, 실제로 EKS·GKE 같은 매니지드 쿠버네티스가 containerd를 직접 쓴다.
dockershim이 사라진 이유
dockerd(도커 데몬)는 CRI를 직접 말할 줄 몰라서, kubelet이 도커와 통신하려면 dockershim이라는 번역기(어댑터)를 따로 둬야 했다. 그런데 도커 내부도 결국 containerd를 쓴다. 그래서 경로를 비교하면 이렇다.
(과거)  kubelet → dockershim → dockerd → containerd → runc   (도커를 거치는 우회로)
(지금)  kubelet ──CRI──▶ containerd ──▶ runc                 (직통)
도커만을 위한 dockershim을 쿠버네티스가 계속 유지하는 것은 불필요한 부담이라, 쿠버네티스 v1.24(2022년)에서 제거됐다. 지금은 kubelet이 CRI를 통해 containerd·CRI-O와 직접 통신한다.
이것은 "도커 이미지를 못 쓴다"는 뜻이 아니다. 이미지는 OCI 표준이라 지금도 그대로 동작한다. 없어진 것은 kubelet이 노드 런타임으로 도커 데몬을 쓰던 경로일 뿐이다.
정리
- 컨테이너 생성은 kubelet → containerd → runc 3단 릴레이로 이뤄진다.
- kubelet은 시키고, containerd는 이미지를 준비하고, runc는 namespace/cgroups로 실제 컨테이너를 만든다.
- 각 단계는 CRI(kubelet ↔ 런타임)와 OCI(런타임 ↔ runc)라는 표준으로 연결돼 부품 교체가 가능하다.
- containerd와 runc는 Docker에서 독립한 프로젝트라, Docker 없이도 쿠버네티스 런타임으로 쓸 수 있다.
- dockershim은 제거됐지만, Docker 이미지(OCI 표준)는 여전히 정상 동작한다.
kubelet ──CRI──▶ containerd ──OCI──▶ runc ──▶ [namespace + cgroups] ──▶ Container
 시킨다           이미지 준비           실제 생성        격리 적용